64 GB RAM,搭配 RTX 5060 Ti 16 GB,這台主機已成功載入並執行 Qwen3.8-Flash-Next UD-IQ4_XS 的推理請求。本次使用的是 Huihui v2 版本,由 Strata 0.1.47 執行;安裝的 64 GB RAM 中,系統可使用總容量以 63.8 GB 計算。主模型的全部 routed experts 約 55.43 GB,啟動紀錄顯示已完整鎖定在實體 RAM,量測快照中 Strata 引擎另使用約 13.39 GB VRAM,實際用量會隨工作負載變動。
讓這個配置成立的關鍵,是模型資料分布在 RAM、VRAM 與磁碟:87.25 GB 的主模型檔案中,約 26.82 GB 的 PLE 表按需從磁碟讀取,GPU 則保存常用專家快取與運算資料。本次快照的全機分頁檔已用約 2.46 GB,無法精確歸屬到 Strata;先前日常運行時約有 1~2 GB 可用 RAM。本文以這次已執行請求後的量測,詳列四類資源的容量與比例,說明這台 64 GB RAM 主機如何跑起模型,以及現有證據能支持的範圍。
本配置另設定 STRATA_,關閉尾端專家略過機制,讓符合該機制略過條件的已選中專家仍參與計算。這項設定會影響解碼速度與輸出結果,是解讀後續效能數據的重要條件。
實測速度:32K Prefill 與 4K Decode
在同一台 RTX 5060 Ti 16 GB、64 GB RAM 主機上,模型為 Huihui v2 UD-IQ4_XS,使用 Strata 0.1.47,上下文上限設定為 64K(65,536 tokens)。以下是另行補測的速度結果;本文的記憶體用量主要來自先前快照,可用 RAM 另列先前日常運行的範圍。
2026-10-24 重測:以下為 Strata 重啟後,沿用相同測試流程取得的新結果。
| 測試 | 第一次 (tok/s) | 第二次 (tok/s) | 第三次 (tok/s) | 中位數 (tok/s) |
|---|---|---|---|---|
| 32K Prefill | 1,268.9 | 1,294.2 | 1,295.3 | 1,294.2 |
| 4K Decode | 43.2 | 39.8 | 48.4 | 43.2 |
測試條件:
- Prefill:每次輸入 32,768 tokens,測量提示詞處理速度。
- Decode:每次輸入 4,096 tokens,完整生成 512 tokens,測量輸出生成速度;「4K」指輸入長度。
- 使用程式碼負載,temperature 0,關閉 thinking。
- 兩項測試各執行三次,共六次請求;每次都確認提示快取命中為 0。
- 速度採引擎回傳計時,中位數由各項測試的三次結果計算。
測量條件與單位
除明確標示 MiB/GiB 的參數單位外,全文容量均以 bytes ÷ 1024³ 換算,統一標為 GB,沿用本機 Windows 記憶體畫面的標示習慣。這是二進位換算,與硬碟廠商以十進位計算的 GB 不同。RAM 比例一律以使用者指定的 63.8 GB 為分母;「63.8 GB 可用容量」在本文指系統可使用的實體 RAM 總容量,不是當下尚未使用的空間。
| 項目 | 配置與量測條件 |
|---|---|
| GPU | NVIDIA GeForce RTX 5060 Ti,VRAM 16 GB |
| VRAM 預留 | --vram-reserve-mib 700:700 MiB |
| RAM | 安裝 64 GB,比例計算採可用總容量 63.8 GB |
| Strata | 0.1.47,CUDA 13; 原始碼對應 commit 76f90e58436d |
| 模型 | Qwen3.8-Flash-Next Huihui v2,UD-IQ4_XS,三個 GGUF 分片 |
| 執行方式 | 完整載入主模型專家 arena; expert-cache auto; prefill auto |
| 尾端專家略過 | STRATA_;已關閉 |
| 上下文與推測解碼 | max-context 65,536、KV int8、spec 4、spec-min-p 0.5、MTP 開啟 |
| KV Cache 配置 | 關閉 KV streaming; 未使用 –kv-resident; KV Cache 全部位於 VRAM |
| 其他配置 | HC Q8 開啟; Vision 開啟且設為 CPU; PLE 使用 direct I/O |
| 時間 | 啟動:2026-10-23 17:47; 主快照:2026-10-24 00:22,UTC+8; 控制程序另行補查 |
| 測量範圍 | 已載入並執行過請求後的現況快照; 不是滿上下文或高負載峰值測試 |
下文「實測」指 Windows 計數器或檔案長度;「配置」來自本次啟動日誌與相同版本原始碼;「估算」包含尚未逐頁去重的跨計數器推算。不同時間的工作量、其他程式與配置會改變結果。
把 RAM 留給專家:關閉 KV streaming
為了將更多 RAM 留給專家權重,此配置移除了 --kv-resident 32768,關閉 KV streaming,讓 KV Cache 完整保留在 VRAM。相較於原先的配置,這省下約 0.77 GB 的 pinned RAM,同時讓 KV Cache 的 VRAM 占用估計增加 0.39 GB,壓縮 GPU 專家快取的可用空間。上下文上限仍為 64K(65,536 tokens),KV 精度維持 INT8。主模型專家權重仍常駐 RAM。
先看四類資源的總覽
| 資源 | 容量/用量 | 比例與分母 | 證據範圍 |
|---|---|---|---|
| VRAM: Strata 引擎 | 13.39 GB | 83.70% /16 GB | Windows GPU 程序專用記憶體快照 |
| RAM: 主模型全部 routed experts | 約 55.43 GB | 86.88% /63.8 GB | 權重有效載荷;本次啟動日誌顯示整個 arena 已鎖定 |
| RAM: Strata 整體 | 粗估約 56.4 GB | 約 88.4% /63.8 GB | 包含引擎、控制與 Vision 程序;跨計數器估算,非逐頁精確總量 |
| 磁碟分頁: 全機已用 | 2.46 GB | 5.35% /46 GB 分頁檔 | 全系統數字,無法分配到單一程序 |
| 磁碟: 模型與配套檔案(含 PLE) | 90.25 GB | 97.64% /本次盤點的 92.44 GB 部署檔案 | 主模型、pack、MTP、Vision |
這四欄不能直接相加成模型大小。磁碟保存模型檔案,RAM 載入專家權重,VRAM 再保存其中一部分專家的快取副本;同一份邏輯權重可能同時占用不同硬體資源。分頁檔本身也位於磁碟,不能在磁碟總量中重複計入。
RAM:55.43 GB 的全部專家放在哪裡?
pack 的專家索引記錄主模型 routed-expert 有效載荷為 59,519,795,200 bytes,即約 55.43 GB;三個 GGUF 的 tensor metadata 也得到相同結果。這包含 48 層、每層 512 個 routed experts,合計 24,576 個「層 × 專家」組合。配置對齊會另有極少量開銷。
日誌中的「44 GB pinned」與「10.78 GB VirtualLock」是同一個 expert arena 的兩個區段,不是兩套額外權重:
| 鎖定方式 | 容量 | 占 63.8 GB RAM | 解讀 |
|---|---|---|---|
| CUDA pinned, 前 39 個 slices | 約 44.65 GB | 69.99% | 原始日誌只印整數 44; 依對應權重區段換算約 44.65 |
| VirtualLock, 其餘尾段 | 約 10.78 GB | 16.90% | CUDA 無法註冊全部區段後,尾段改用 Windows 鎖定 |
| 主模型專家有效載荷合計 | 約 55.43 GB | 86.88% | 兩種方式覆蓋整個 arena; 尾段鎖定數字含對齊差異 |
依照本次啟動日誌與 相同版本的 pinned 實作,程式先逐段執行 CUDA host registration,再只對剩餘尾段呼叫 resident lock。尾段成功訊息表示該區段的 VirtualLock 已完成,因此可判定本次載入時,全部主模型專家 arena 都成功鎖在實體 RAM。這是日誌及程式路徑的判定,並非本次取得了整個程序的逐頁掃描結果。
Microsoft 的 VirtualLock 文件指出,成功鎖定的頁面在解除鎖定或程序終止前會保留於實體記憶體,不會寫入 pagefile。CUDA 的 page-locked host memory同樣屬於不可換出的主機記憶體。整體 CUDA 註冊失敗或 large pages 未成功,不能單憑這兩句就斷言專家已被換到磁碟;本次仍有逐段 pinned 與 VirtualLock 的成功後備路徑。
這裡的「全部專家」特指主模型 routed experts。Embedding、PLE、主模型其他權重、MTP 與 Vision 另外列帳;並不表示磁碟上 87.25 GB 的整個 GGUF 都常駐 RAM。
扣除專家後的 8.37 GB,還要容納哪些東西?
63.8 − 55.43 ≈ 8.37 GB。這約占 RAM 的 13.12%,必須共同容納 Strata 其他主機資料、Windows、驅動程式、其他應用程式及當下可用空間。它不是「Windows 固定使用量」,也不是全部留給 Strata 的餘裕。
| Strata 其他 RAM 項目 | 容量 | 占 63.8 GB | 數字性質/說明 |
|---|---|---|---|
| Token embedding, Q8_0 | 約 0.6290 GB | 0.9860% | 本次載入 mapped host memory; 由 tensor 大小核對 |
| PLE 預填雙緩衝 | 約 0.1563 GB | 0.2449% | 8,192-token chunk 的配置計算; 不是整張 PLE 表 |
| 專家 host staging, 預設 16 slots | 約 0.05188 GB | 0.0813% | 按最大 expert blob 與預設槽位計算,非獨立駐留量實測 |
| Prefill 路由 ids/slots/sources | 約 0.000916 GB | 0.001435% | 三組主機整數陣列的配置計算 |
| Token ID 主機/上傳緩衝 | 約 0.000061 GB | 0.000096% | 8,192-token chunk 的配置計算 |
| QSA steps 主機/上傳緩衝 | 約 0.000244 GB | 0.000383% | 依 4 steps 計算 |
| Python 控制程序工作集 | 約 0.0144 GB | 約 0.0226% | 補查時的工作集,不代表 commit 或全部配置量 |
| Vision CPU 程序工作集 | 約 0.00057 GB | 約 0.0009% | 快照當下很小; 不能據此推定視覺權重不占任何資源 |
| 其他配置與開銷 | 未單獨量得 | 未能精確拆分 | 路由分組表、CPU worker stack/scratch、驗證 host staging、checkpoint、索引與 CUDA/驅動管理資料等 |
配置容量與當下工作集不是同一種數字,上表不應直接相加當作精確常駐量。啟動時會為後續 pinned buffers 暫時預留約 0.7813 GB,並在初始化過程中逐步交還或釋放。這是啟動階段的暫時預留空間,不應另外計入永久常駐 RAM,也不同於先前日常運行時剩餘的 1~2 GB 可用 RAM。程式依據可參考 prefill 緩衝配置及 pin budget 的釋放流程。
Strata 整體與作業系統各占多少 RAM?
Windows 此次回報 Strata 主引擎的工作集約 10.79 GB、GPU SharedUsage 約 45.60 GB。Shared GPU memory 使用的是系統 RAM,不是額外的實體 VRAM,也不是 pagefile。只看程序的 10.79 GB 工作集,會漏掉此配置下由 GPU/驅動相關計數器反映的大量主機記憶體。
將上述兩個計數器與控制、Vision 程序工作集交叉對照,可得到 Strata 整體約 56.4 GB的量級估算。但這些計數器沒有逐頁去重;Microsoft 對 GPU 計數器的說明也提醒程序數值可能包含共享資源,因此下表只能作為粗略分配,不能視為精確會計帳:
| RAM 粗估分配 | 約 GB | 占 63.8 GB |
|---|---|---|
| 主模型專家有效載荷 | 55.43 | 86.88% |
| Strata 其餘部分 | 0.97 | 約 1.52% |
| Windows、驅動與其他程式 | 5.4~6.4 | 約 8.46~10.03% |
| 先前日常運行時可用 RAM | 1~2 | 約 1.57~3.13% |
其中「Strata 其餘部分」是約 56.4 GB 減去專家有效載荷的估算差額;「Windows、驅動與其他程式」則以 63.8 − 56.4 −(1~2)≈ 5.4~6.4 GB 推算,承接 Strata 估算量的誤差,並非另一次獨立量測。可用 RAM 越多,這項估算餘額越小。可靠度較高的結論是:專家已占掉約 86.88%,其餘用途合計僅剩約 8.37 GB 的容量預算。先前日常運行時可用 RAM 約 1~2 GB,占總容量約 1.57~3.13%。
VRAM:16 GB 顯存的配置與預留空間
16 GB 顯存供 Strata 的 GPU 專家快取、其他權重及執行時配置使用。--vram-reserve-mib 設為 700 MiB,作為決定專家快取大小時保留的一般餘裕。本配置的 Vision 影像編碼器在 CPU 執行,不需要為編碼器另留 GPU 記憶體。下方的 13.39 GB 是量測時的 Strata 用量快照,不是固定上限或峰值。
量測時的 Windows GPU 專用記憶體計數器顯示,Strata 引擎使用約 13.39 GB,占 16 GB 的 83.70%。全卡計數器顯示約 14.07 GB,與 Strata 程序計數器的差額約 0.67 GB,可作為其他程序與系統圖形負載的量級參考;此差額未逐資源去重:
| VRAM 用量快照 | GB | 占 16 GB |
|---|---|---|
| Strata 引擎 | 13.39 | 83.70% |
| 其他/系統差額(估算) | 約 0.67 | 4.22% |
| 剩餘容量 | 約 1.93 | 12.09% |
| 全卡已用 | 14.07 | 87.91% |
以下將啟動日誌中的已知配置,與上述程序快照對照。配置訊息本身有四捨五入,且部分動態緩衝會隨請求變動:
| Strata VRAM 項目 | 約 GB | 占 16 GB | 內容/邊界 |
|---|---|---|---|
| 專家 GPU 快取 | 6.1500 | 38.44% | 2,732 個常駐槽位 |
| 原生投影權重 | 3.5343 | 22.09% | 已包含 HC Q8 約 0.63 GB |
| Canonical 小權重 | 0.2109 | 1.32% | 與原生投影分開配置 |
| MTP draft layer | 0.8555 | 5.35% | 包含草稿專家、dense 與該層狀態/緩衝 |
| 原生輸出 head | 0.4857 | 3.04% | 主模型輸出投影 |
| MTP draft head | 0.2079 | 1.30% | 與 MTP layer 分開配置 |
| Verify device buffers | 0.0853 | 0.53% | 最多 6-token 驗證視窗 |
| 上述已知項目小計 | 11.5295 | 72.06% | 啟動配置近似合計 |
| 未完整細分的差額 | 1.8621 | 11.64% | 主模型 KV/state、prefill/activation、CUDA 配置與其他緩衝等; 不是單一項目的實測 |
| Strata 程序專用 VRAM 合計 | 13.3917 | 83.70% | Windows 計數器快照 |
先前執行時,GPU 快取放入 2,732 個「層 × 專家」槽位,約為 24,576 個總槽位的 11.12%;這是槽位數量比例,不是命中率。快取約 6.15 GB,占 VRAM 38.44%。它是 RAM 專家權重的 GPU 副本,並不會把 RAM 中的全部專家替換掉。
閱讀日誌時有三個容易重複加總的地方:
- HC Q8 約 0.63 GB 已包含於原生投影約 3.53 GB。原始碼的容量統計已將它計入。
- Prefill 借用約 3.49 GB cache,包含於 6.15 GB 專家快取。這是既有槽位的借用,不是再配置一塊等量 VRAM。
- MTP layer 的專家、dense 與該層狀態屬於 0.8555 GB 的內部分項。MTP draft head 則是後續另行配置,可獨立列帳。
上表的約 1.86 GB 差額未取得完整逐配置快照,不能直接改名為「KV cache 1.86 GB」。本次雖設定最大上下文 65,536,也不代表已把這個長度的所有運行峰值測完。
磁碟分頁:全機用了 2.46 GB,Strata 用了多少?
| 分頁指標 | 容量 | 比例/解讀 |
|---|---|---|
| pagefile.sys 已配置容量 | 46.00 GB | 100% 的分頁檔容量 |
| 全系統快照已用 | 2.4609 GB | 占分頁檔 5.35% |
| 全系統峰值使用量 | 2.4756 GB | 占分頁檔 5.38%; 非本模型專屬峰值 |
| Strata 主模型已鎖定專家 | 鎖定期間不寫入 pagefile | 依成功鎖定語意與本次啟動紀錄判定 |
| Strata 其他未鎖定資料/Vision/控制程序 | 未能精確歸屬 | 本次沒有取得逐程序的實際 pagefile 駐留量 |
46 GB 是分頁檔本身的配置容量,2.46 GB 是先前快照中全機的使用量。不能寫成「Strata 另外使用 46 GB 虛擬記憶體」,也不能把全機的 2.46 GB 全部算給模型。只憑這組資料,可以確認系統整體有分頁檔使用量,但不能確認其中多少屬於 Strata 的其他資料。
主引擎的 private committed memory 約 72.95 GB,Vision 程序約 1.36 GB;這些是 commit 指標,不是實際寫入磁碟的量。例如不能用「72.95 − 56.4」推算 Strata 有十多 GB 在 pagefile。Microsoft 的記憶體效能指標對照也把部分名稱含 Page File 的程序計數器對應到 Commit Size,而不是分頁檔實際占用。
在約 00:02 的短時間閒置採樣中,分頁輸出率持續為 0;00:22 主快照的分頁輸入、輸出率也為 0。這表示那些觀測時刻沒有量到持續換出活動,不能證明長時間推理、模型載入或其他工作負載都完全沒有磁碟分頁。這次對引擎及 Vision 程序做進一步記憶體查詢時遭 Windows 存取權限拒絕,因此保留逐程序歸屬為未知。
磁碟分頁就是虛擬記憶體嗎?
兩者有關,但不能畫上等號。虛擬記憶體是程序使用虛擬位址,由作業系統映射到實體 RAM 或其他後備儲存的機制;pagefile 分頁是其中將可換出頁面保存在磁碟分頁檔的做法。已鎖在 RAM 的專家仍透過虛擬位址存取,只是不會在鎖定期間被換到 pagefile。
此外,Strata 按需讀取磁碟上的 PLE 表、啟動時讀取 GGUF、讀入 DLL 或檔案映射頁面,都可能造成磁碟 I/O;這些不等於 pagefile 換頁。硬性分頁錯誤也可能來自一般檔案,不能只看硬性錯誤就斷定模型正在使用磁碟分頁檔。
磁碟:87.25 GB 主模型,90.25 GB 模型部署,92.44 GB 含程式
檔案容量採檔案長度加總;不是下載壓縮包大小,也不是逐一量測 NTFS 配置叢集。一般檔案的實際磁碟配置可能因壓縮、稀疏或叢集對齊略有差異。本次只盤點這個模型所需的模型檔案與已安裝程式,不包含其他模型、轉換來源備份、安裝包、日誌及 Windows 本身。
| 磁碟項目 | GB | 占 92.44 GB 部署盤點 | 內容 |
|---|---|---|---|
| 主模型 GGUF, 三個分片 | 87.2487 | 94.39% | Huihui v2 UD-IQ4_XS |
| 配套 pack 與 tokenizer | 1.3933 | 1.51% | dense.bin、索引、轉換資訊與 tokenizer |
| MTP runtime | 0.7677 | 0.83% | dense、experts、draft vocabulary 等 |
| Vision mmproj | 0.8452 | 0.91% | 視覺投影模型 |
| Strata 已安裝主程式目錄 | 1.3653 | 1.48% | 含 control、內附 engine-bundle、harness、host、Node 與啟動程式 |
| 目前使用的獨立 engine component | 0.8160 | 0.88% | 0.1.47 CUDA 13; 與主程式內附引擎各有一份 |
| 總計 | 92.4363 | 100% | 其中模型及配套檔案合計 90.2550 GB |
內附 engine-bundle 與目前使用的 component 在本機確實各有一份,因此磁碟盤點把兩份都列入。這不表示執行時會在 RAM 或 VRAM 內載入兩套相同引擎。
若只比較模型部署的 90.25 GB,主模型 GGUF 占 96.67%、pack 占 1.54%、MTP 占 0.85%、Vision 占 0.94%。
主模型 87.25 GB 的內容拆分
以下讀取 GGUF headers 與 tensor metadata 計算,未把整個模型重新載入 RAM。分母僅為三個主模型 GGUF,與上一表的部署總量不同:
| GGUF 內容 | GB | 占 87.25 GB 主模型檔案 |
|---|---|---|
| 主模型 routed experts | 55.4321 | 63.5335% |
| PLE 大表 | 26.8222 | 30.7423% |
| Token embedding | 0.6290 | 0.7210% |
| 原生輸出 head | 0.4857 | 0.5566% |
| HC projections | 0.6290 | 0.7210% |
| Shared-expert 相關 tensors | 0.2339 | 0.2681% |
| 其他 tensors | 3.0064 | 3.4458% |
| Headers、metadata 與 padding | 0.0103 | 0.0118% |
| 合計 | 87.2487 | 100% |
PLE 約 26.82 GB 是「模型檔案比 RAM 專家權重大很多」的主要原因。本次採 direct I/O 按需讀取,不把整張表常駐 RAM;預填時的約 0.1563 GB 主機雙緩衝另列於 RAM 表中。PLE 存在磁碟上是模型的資料配置策略,並不是專家因 RAM 不夠而被寫進 pagefile。
本機所在磁碟區容量約 1,861.88 GB。上述 92.44 GB 模型與程式檔案約占磁碟區 4.96%。若另外把系統已配置的 46 GB 分頁檔納入空間規劃,兩者合計約 138.44 GB,占 7.44%;其中分頁檔為全系統共用,不能全部歸為 Strata 專用空間。已用的 2.46 GB 是 46 GB 裡的一部分,不應再加一次。
64 GB RAM 已能跑起,實際餘裕有多少?
這次的證據支持:主模型全部 routed experts 約 55.43 GB,已在啟動時完整鎖進 RAM;量測快照中 Strata 引擎約使用 13.39 GB 專用 VRAM,保存常用專家快取與其他運算資料。模型能運作的關鍵包含 CPU/GPU 分工、部分專家的 VRAM 副本,以及 PLE 按需從磁碟讀取。
容量壓力主要出現在 RAM:專家之外只有約 8.37 GB 的總預算,先前日常運行時可用 RAM 約 1~2 GB。即使鎖定專家本身不會分頁,Windows、其他程式及 Strata 未鎖定的資料仍可能承受記憶體壓力。全機已有約 2.46 GB pagefile 使用量,但這次資料不足以把它精確分配到 Strata。
因此,對這台主機最準確的描述是:全部主模型專家已鎖在 RAM,整體記憶體餘裕很小;不能進一步宣稱整台電腦或 Strata 所有資料都完全不用磁碟分頁。本次沒有進行滿上下文峰值或長時間壓力測試,本文數字應作為指定版本、設定與時間點的容量盤點。
資料來源與可重現範圍
- 本機 Windows CIM:作業系統實體記憶體、程序 WorkingSetSize/PrivatePageCount、GPUProcessMemory/GPUAdapterMemory、Win32_PageFileUsage;主快照時間為 2026-10-24 00:22(UTC+8)。
- 本次 Strata 0.1.47 啟動紀錄、模型專家索引、GGUF tensor metadata 及檔案長度,經統一容量換算與分項整理。
- Strata 對應版本原始碼,用來核對鎖定後備路徑、buffer 容量與重複統計項目。
- Microsoft:VirtualLock;Memory Performance Information;GPUs in the Task Manager。
- NVIDIA:Page-locked Host Memory。
百分比以未四捨五入的數字計算;表內四捨五入可能使加總略有差異。「未知」表示本次未取得足夠資料,並不代表容量為零。
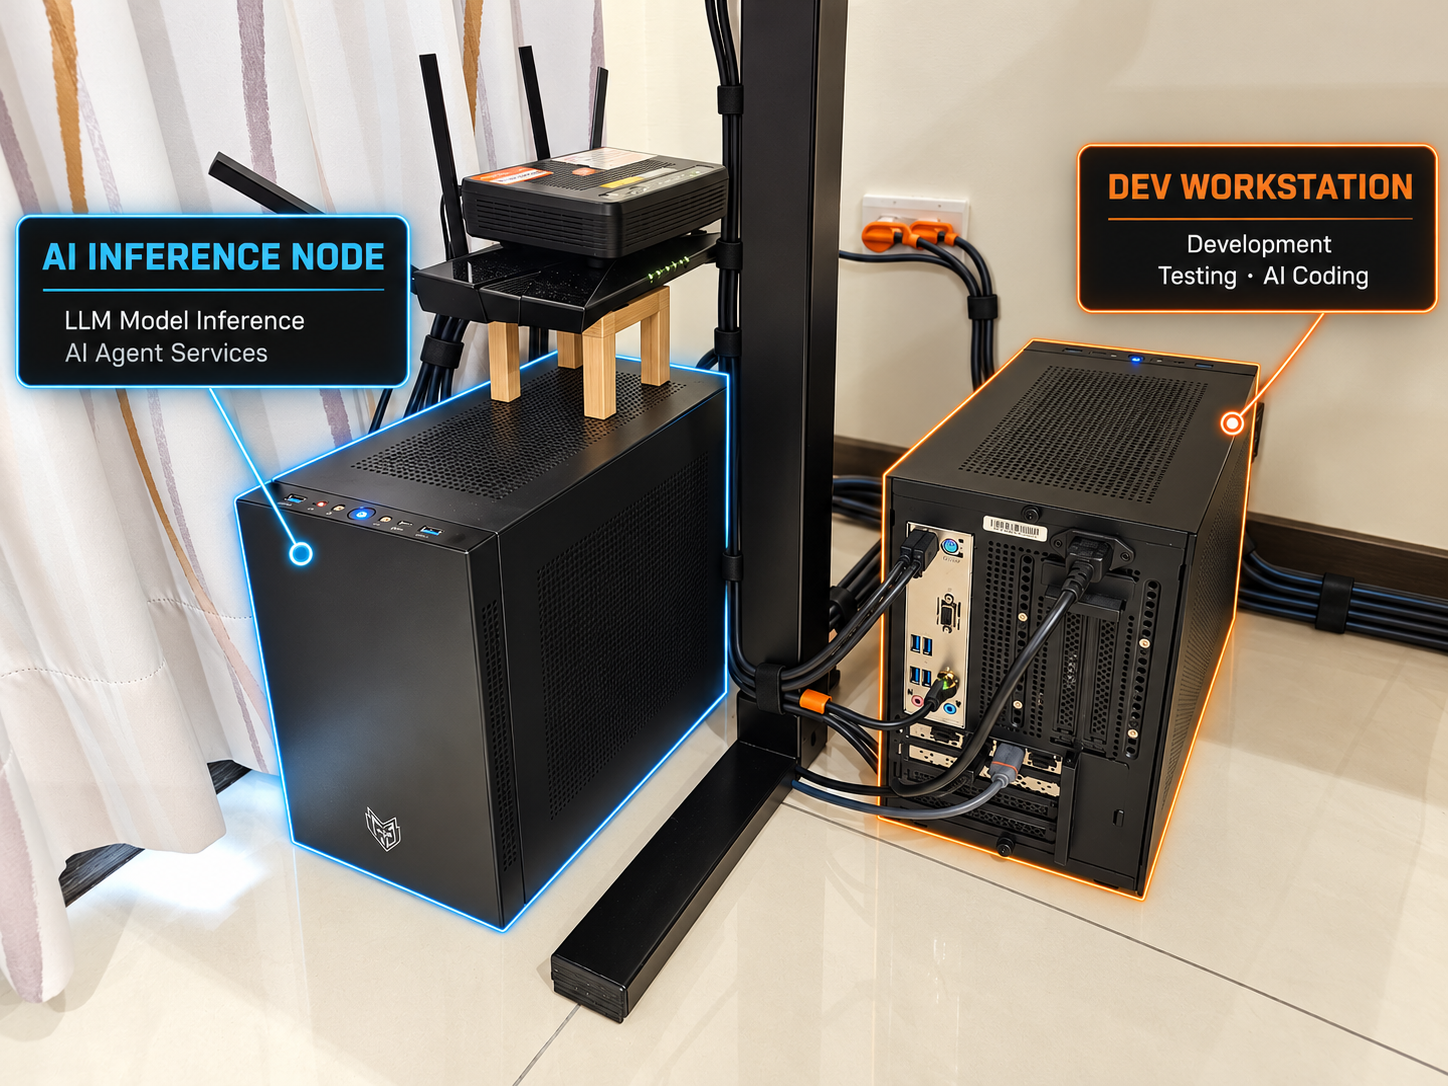
雙機分工:推理與開發各自保有運算資源
上圖左側的 AI INFERENCE NODE 專責模型推理與 AI Agent 服務,右側的 DEV WORKSTATION 則負責程式開發、測試與 AI Coding。兩台主機各自使用獨立的 CPU、GPU 與記憶體,讓推理服務與開發工作不會互相搶占同一台主機的運算資源,也能把推理主機的記憶體空間留給模型。
將 IDE、編譯與測試等開發工作交由 DEV WORKSTATION 處理,可以減少 AI INFERENCE NODE 上的 RAM 占用,把 64GB RAM 中更多可用空間留給模型。雙機配置讓推理主機騰出更多 RAM,因而有更多空間載入並執行更大的模型。對本文這種記憶體餘裕有限的配置,這正是將推理服務與日常開發分開的實際價值。
| 項目 | AI INFERENCE NODE 推理主機(左) | DEV WORKSTATION 開發主機(右) |
|---|---|---|
| 主要用途 | 模型推理、AI Agent 服務 | 程式開發、測試、AI Coding |
| CPU | Intel Core i7-11700 | Intel Core i7-11700 |
| 主機板 | ASUS PRIME B560M-K | ASUS PRIME B560M-K |
| 顯示卡 | ASUS Dual GeForce RTX 5060 Ti 16GB | ZOTAC GAMING GeForce RTX 4060 8GB SOLO |
| 記憶體 | Micron Crucial PRO DDR4-3200 64GB(32GB × 2) | ADATA DDR4-3600 32GB(16GB × 2) |
| SSD 1 | Corsair Force MP600 2TB | Corsair Force MP600 2TB |
| SSD 2 | Seagate FireCuda 520 2TB | Seagate FireCuda 520 2TB |
| HDD | Toshiba MG08ACA16TE 16TB × 1 | Toshiba MG08ACA16TE 16TB × 2 |
| 作業系統 | Windows 11 Home | Windows 11 專業版 |
| 機殼 | FSP 全漢 CST350 | FSP 全漢 CST350 |
| 電源供應器 | FSP 全漢金鋼彈 550W 80PLUS 金牌/SFX | FSP 全漢金鋼彈 550W 80PLUS 金牌/SFX |


留言討論