在 i7-11700、RTX 5060 Ti 16GB 与 64 GiB RAM 上,IQ2_XS、IQ3_XXS、IQ3_S 的九次实测 Decode 中位数分别为 65.55、51.30、42.45 tokens/s。本文完整比较三款模型的 Prefill/Decode、逐次结果、作者速度与换算耗时、LiveCodeBench 分数、下载大小,以及 RAM 用量和剩余容量。IQ2_XS 测速使用 Swift 1.5,两款 IQ3 使用原版;品质分数另列原版量化,避免混为同一模型。
Strata 系列:模型比较与实测 · 硬件公式与验证 · 升级成本与效益
三款模型:九次实测总览
下表及后方作者比较采用同一组基准:IQ2_XS/IQ3_XXS 为 2026-10-11 的 Strata 0.1.41;IQ3_S 为 2026-10-15 的 0.1.43.1。每款模型的 Prefill/名义 32K、Decode/名义 4K 各九次,共 54 次引擎运行。IQ3_XXS 的新版重测另列,不混入这组中位数。
| 模型 | Prefill 中位数 | Prefill 范围 | Decode 中位数 | Decode 范围 |
|---|---|---|---|---|
| IQ2_XS (Swift 1.5) | 1,622.10 | 1,600.68–1,627.45 | 65.55 | 61.08–66.93 |
| IQ3_XXS | 1,666.44 | 1,648.03–1,667.46 | 51.30 | 50.78–53.42 |
| IQ3_S | 1,626.96 | 1,581.32–1,641.58 | 42.45 | 41.07–43.03 |
| 项目 | IQ2_XS | IQ3_XXS | IQ3_S |
|---|---|---|---|
| 模型变种 | Swift 1.5 | 原版 Qwen | 原版 Qwen |
| 测试日期 | 2026-10-11 | 2026-10-11 | 2026-10-15 |
| Strata | 0.1.41 | 0.1.41 | 0.1.43.1 |
| NVIDIA 驱动 | 591.86 | 591.86 | 610.88 |
| KV streaming | 开;resident 32,768 | 开;resident 32,768 | 关;安装器依 RAM 选择 |
三款均使用同一台主机、保存的替代源代码提示与 token IDs;并非作者未公开的原文。名义 32K/4K 实际输入 31,566/3,562 tokens,Prefill 计时涵盖 31,565/3,561 tokens,最后一个提示 token 留给首步 Decode。每次 greedy 生成 256 tokens;65,536 上下文、INT8 KV、MTP spec 4/min-p 0.5、expert-cache/prefill auto、显存预留 1,500 MiB。
测速期间停止 HTTP 与看图服务,每次启动全新引擎,零提示缓存复用,未清除操作系统文件缓存;计时不含模型加载。两组旧版九次结果由原三次加六次组成,IQ3_S 为九次新测;未剔除较慢样本。各表同一行只是各自第 N 次运行,不代表同时或交错测试。模型变种、KV 与驱动差异见上表,因此这是实际配置比较,不能把差距全归因于量化。
| 次数 | IQ2_XS (Swift 1.5) | IQ3_XXS | IQ3_S |
|---|---|---|---|
| 1 | 1,600.68 | 1,648.03 | 1,626.22 |
| 2 | 1,619.99 | 1,652.45 | 1,581.32 |
| 3 | 1,620.37 | 1,667.16 | 1,603.99 |
| 4 | 1,623.67 | 1,666.63 | 1,626.96 |
| 5 | 1,622.78 | 1,667.46 | 1,621.56 |
| 6 | 1,627.45 | 1,667.13 | 1,637.45 |
| 7 | 1,622.76 | 1,665.17 | 1,641.58 |
| 8 | 1,607.08 | 1,666.44 | 1,637.69 |
| 9 | 1,622.10 | 1,664.15 | 1,639.34 |
| 次数 | IQ2_XS (Swift 1.5) | IQ3_XXS | IQ3_S |
|---|---|---|---|
| 1 | 61.08 | 51.54 | 41.89 |
| 2 | 64.07 | 50.85 | 42.10 |
| 3 | 64.78 | 50.78 | 42.44 |
| 4 | 66.18 | 51.01 | 42.45 |
| 5 | 65.55 | 51.20 | 41.07 |
| 6 | 66.92 | 51.63 | 42.73 |
| 7 | 63.27 | 51.30 | 42.60 |
| 8 | 66.93 | 53.42 | 43.03 |
| 9 | 66.93 | 51.57 | 42.77 |
版本重测与数据完整性
| 模型 | 0.1.41 | 0.1.43.1 | 新版速度变化 |
|---|---|---|---|
| IQ2_XS (Swift 1.5) | 1,622.10 / 65.55 | 未测 | 无同模型两版配对 |
| IQ3_XXS | 1,666.44 / 51.30 | 1,665.73 / 51.65 | Prefill −0.04%; Decode +0.68% |
| IQ3_S | 未测 | 1,626.96 / 42.45 | 无同模型两版配对 |
只有 IQ3_XXS 完成同模型两版各九次重测;0.1.43.1 采用 2026-10-13 的有效重测数据,已作废的批次不使用。新版逐次结果保留如下;作者比较与 v4 预测公式仍使用 0.1.41 的 IQ3_XXS 基准。
| 次数 | Prefill / 32K | Decode / 4K |
|---|---|---|
| 1 | 1,672.80 | 51.65 |
| 2 | 1,672.26 | 51.65 |
| 3 | 1,665.73 | 51.23 |
| 4 | 1,667.96 | 51.50 |
| 5 | 1,642.28 | 51.75 |
| 6 | 1,655.38 | 51.24 |
| 7 | 1,655.48 | 51.77 |
| 8 | 1,669.69 | 52.43 |
| 9 | 1,655.81 | 51.77 |
本机与作者的同模型比较
| 项目 | 本机 | Strata 作者 |
|---|---|---|
| CPU | Intel Core i7-11700 | AMD Ryzen 5 7600 |
| GPU | RTX 5060 Ti 16GB | RTX 5070 12GB |
| 显卡连接 | PCIe 4.0 ×8 | PCIe 5.0 ×16 |
| RAM | 64GB DDR4-3200,双信道 | 64GB DDR5-5200,信道未确认 |
IQ2_XS 双方均使用 Swift 1.5;IQ3_XXS、IQ3_S 双方均使用原版 Qwen。本机 IQ2_XS/IQ3_XXS 保留 2026 年 10 月 11 日 Strata 0.1.41 各九次中位数;IQ3_S 采用 10 月 15 日 Strata 0.1.43.1 各九次中位数。作者每格为单次测量。下表秒数统一按 51,200 输入+4,096 输出 tokens换算。
| 模型/项目 | 本机速度 | 作者速度 | 作者速度提升 | 本机秒数 | 作者秒数 | 作者耗时减少 |
|---|---|---|---|---|---|---|
| Swift IQ2_XS/Prefill | 1,622.10 | 2,092.02 | +29.0% | 31.6 | 24.5 | 22.5% |
| Swift IQ2_XS/Decode | 65.55 | 78.60 | +19.9% | 62.5 | 52.1 | 16.6% |
| Swift IQ2_XS/合计 | — | — | — | 94.1 | 76.6 | 18.6% |
| 原版 IQ3_XXS/Prefill | 1,666.44 | 1,745.16 | +4.7% | 30.7 | 29.3 | 4.5% |
| 原版 IQ3_XXS/Decode | 51.30 | 61.64 | +20.2% | 79.8 | 66.5 | 16.8% |
| 原版 IQ3_XXS/合计 | — | — | — | 110.6 | 95.8 | 13.4% |
| 原版 IQ3_S/Prefill | 1,626.96 | 1,624.07 | −0.2% | 31.5 | 31.5 | −0.2% |
| 原版 IQ3_S/Decode | 42.45 | 53.30 | +25.6% | 96.5 | 76.8 | 20.4% |
| 原版 IQ3_S/合计 | — | — | — | 128.0 | 108.4 | 15.3% |
耗时减少=1−作者秒数÷本机秒数;速度提升=作者 tokens/s÷本机 tokens/s−1,均以未四舍五入数值计算。这是模型推论时间换算,不是完整 coding-agent 任务的实测耗时。
作者使用 Strata 0.1.26、英语 MTP 词汇表;本机使用 0.1.41/0.1.43.1、CJK MTP 词汇表,提示及上下文/KV 条件也不完全相同,因此不能把差距全归因于硬件或量化。本机原版 IQ3_XXS 比 Swift IQ2_XS 的 Prefill 快 2.7%、Decode 慢 21.7%,同时涉及模型变种与量化差异。IQ3_S 的 KV 与驱动差异见上方测试条件;作者速度提升或耗时减少为负值时,表示作者较慢。
ISTA-DASLab 原版量化:完整品质评测
以下完整列出 ISTA-DASLab 模型卡公布的原版 GSQ-RCO 品质评测,于 2026-10-15 核对;包含 IQ2_XS、IQ3_XXS、IQ3_S,另列 Q2_0 与 BF16 基准。不包含 Swift 1.5,也不是本文在 Strata 上重跑的品质测试。
上方 IQ2_XS 测速使用 Swift 1.5;本节 IQ2_XS 的分数与 68.0 GB 下载量属于 ISTA 原版。IQ3_XXS/IQ3_S 的测速与品质分数皆对应原版量化,但品质测试环境与本机测速仍不同。
| 版本 | AIME25 | GPQA-Diamond | LiveCodeBench v6 | Task avg(三项平均) |
|---|---|---|---|---|
| BF16 | 100.00 | 91.92 | 87.43 | 93.12 |
| Q2_0 | 96.67 | 89.39 | 81.14 | 89.07 |
| IQ2_XS | 96.67 | 87.37 | 83.43 | 89.16 |
| IQ3_XXS | 100.00 | 91.41 | 86.29 | 92.57 |
| IQ3_S | 100.00 | 92.93 | 86.86 | 93.26 |
AIME25 对应数学推理、GPQA-Diamond 对应科学问答、LiveCodeBench v6 对应代码生成。Task avg 只平均这三项,不是所有测试的总分,也不是完整 coding-agent 任务成功率。
| 版本 | 平均 bpw | 下载大小(GB) | ZS avg | recovery |
|---|---|---|---|---|
| BF16 | 16.00 | 354 | 76.94 | 100.0% |
| Q2_0 | 2.40 | 66.4 | 78.00 | 101.4% |
| IQ2_XS | 2.50 | 68.0 | 77.16 | 100.3% |
| IQ3_XXS | 3.00 | 75.8 | 77.23 | 100.4% |
| IQ3_S | 3.50 | 83.6 | 未公布 | 未公布 |
ZS avg 是 ARC-Easy、ARC-Challenge、HellaSwag、WinoGrande、PIQA 五项零样本测试的平均;recovery 是 ZS avg 相对 BF16 的比例,不是 Task avg 的保留率。模型卡未提供 IQ3_S 的这两项数值,也未逐项列出五个零样本测试分数,因此不自行补估。
bpw 是 Transformer 权重的平均位数,不包含固定精度的 n-gram 分片;下载大小包含两个分片,使用十进制 GB,不等于运行时 RAM 用量。
IQ3_XXS 比 IQ2_XS 的 LiveCodeBench 高 2.86 分;IQ3_S 再提高 0.57 分、GPQA-Diamond 提高 1.52 分,下载增加 7.8 GB。IQ3_S 的 Task avg 93.26 略高于 BF16 的 93.12,但 LiveCodeBench 仍低 0.57 分。ISTA 将这类小幅超过 BF16 的结果视为评测波动,不能据此宣称量化后能力更强。
图中保留 LiveCodeBench 折线,另加入三项平均(AIME25、GPQA-Diamond、LiveCodeBench v6 的平均),纵轴从 80 分起以放大差异。两项指标各有 BF16 虚线基准。Coder IQ1_M 裁剪 50% 专家,下载 58.4 GB、LiveCodeBench 86.28,独立标示;其三项平均未公布,因此不绘制该点。
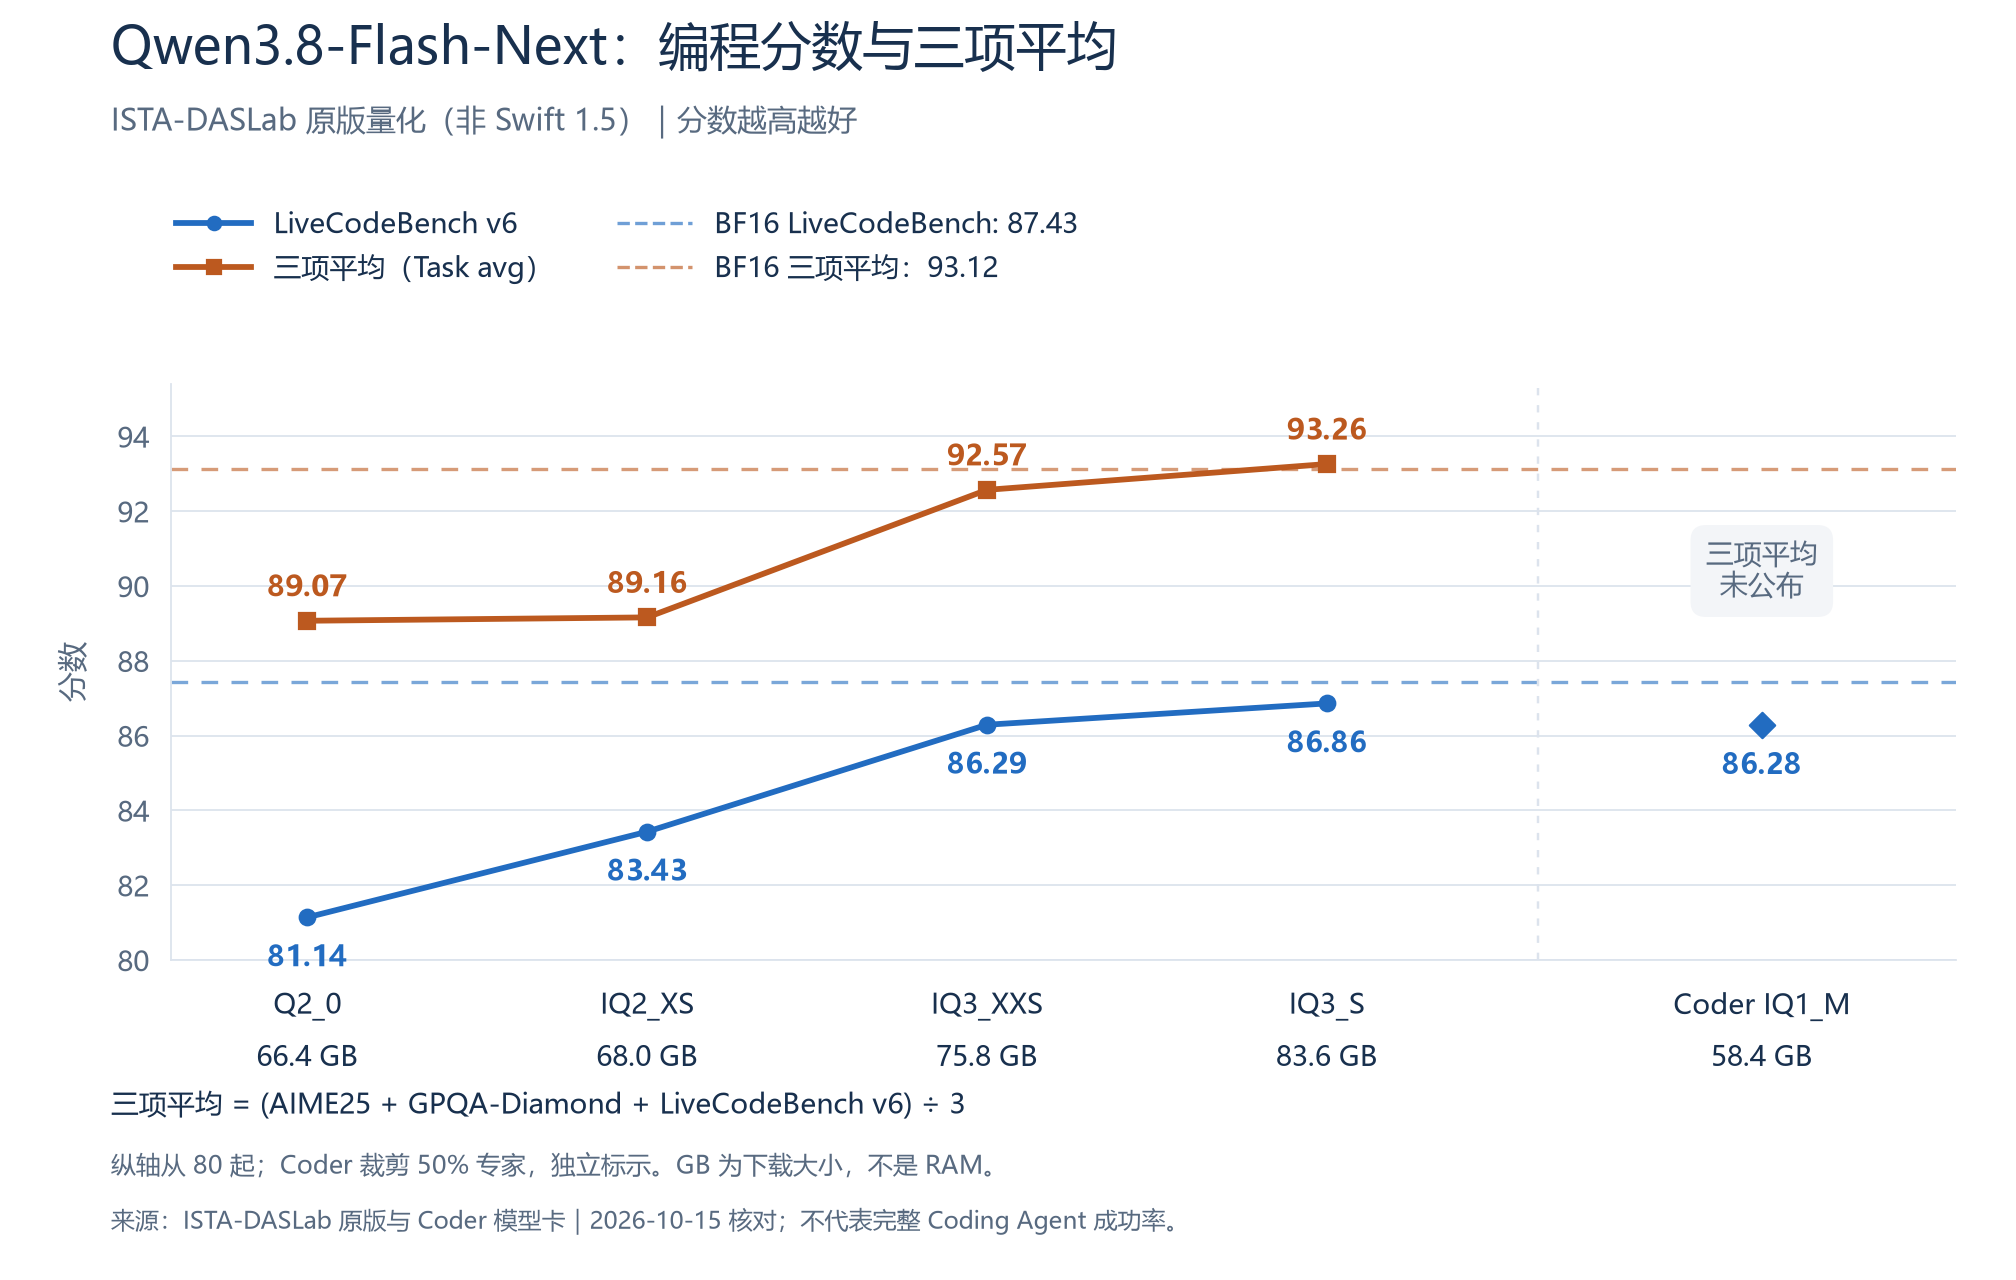
来源:ISTA-DASLab 原版量化完整评测、模型大小与 bpw 定义、Coder 模型卡。原版模型卡没有提供这三款的 SWE-bench/完整 Coding Agent 任务成功率,不能用上述分数代替。
64 GiB RAM 还剩多少?
本机安装 64.00 GiB,Windows 可使用总容量 63.84 GiB。以下用同一容量比较三款模型;本节一律采用 GiB,概估值不是精密测量。
| 项目 | IQ2_XS | IQ3_XXS | IQ3_S |
|---|---|---|---|
| 安装总容量 | 64.00 | 64.00 | 64.00 |
| Windows 可使用总容量 | 63.84 | 63.84 | 63.84 |
| RAM 中的专家权重:约 | 33.53 | 40.05 | 46.57 |
| 模型整体 RAM 概估 | 39.12(官方) | 45.63(官方) | 52.15(本文推算) |
| 扣除模型概估后剩余 | 24.72 | 18.20 | 11.69 |
| 本机卸载/重载实测增量,含看图 | 未测量 | 44.12 | 未测量 |
| 扣除实测增量后剩余 | 未测量 | 19.72 | 未测量 |
IQ2_XS/IQ3_XXS 整体概估沿用官方“专家权重+其他开销”口径。官方未列出 IQ3_S 的同口径总量:本文以官方专家大小加上前两款约 5.59 GiB 的其他开销,推算为 52.15 GiB,不是 IQ3_S 实测或官方直接公布的总量。IQ2_XS 的官方数字属于原版量化;Swift 1.5 仅可按相近架构作容量参考,未另测量。以上将官方十进制 GB 概估换算成 GiB;保留两位小数仅便于比较,不代表测量精度。
剩余容量仍包含 Windows 与其他程序已使用的部分,不是当前空闲 RAM。IQ3_XXS 的 44.12 GiB 来自 2026-10-13、65,536 上下文且启用看图时,整机卸载/重载前后差值;受缓存与后台活动影响,不是进程独占用量。官方概估与实测分开扣除,不能重复扣;差额以未四舍五入数值计算。
数据定义见 Strata RAM 概估与 专家权重与容量条件。下载文件、RAM、VRAM 是不同项目;MODELS 的 RAM+VRAM 栏不能直接当成系统 RAM 用量。
三款模型怎么选
| 模型 | 适合的优先需求 | 代价 |
|---|---|---|
| IQ2_XS | 优先回答生成速度、留更多 RAM 给开发工具 | 本机测速是 Swift;原版品质分数不可直接套用 |
| IQ3_XXS | 兼顾原版品质与 RAM 空间 | 生成较慢;仍须替开发工具保留内存 |
| IQ3_S | 优先原版量化的 LiveCodeBench 成绩 | 生成最慢;64 GiB 主机可留给其他工作的容量最少 |
原版 IQ3_XXS 比原版 IQ2_XS 的 LiveCodeBench 高 2.86 分;IQ3_S 再高 0.57 分。在这台主机上,三款的 Prefill 接近,主要差别在 Decode 和 RAM 预算。这些分数衡量编程题,不能保证长时间 coding-agent 任务不会中断或成功完成。
测速来源
- 作者 Strata 0.1.26 测速说明与逐次原始数据。
- Strata 技术说明。
- 本机 Swift 使用固定版本模型档;作者数据未提供文件 SHA,无法确认逐比特相同。
- 本机九次原始输出、提示、设置与 RAM 量测纪录由测试者保存;本文列出汇总及新版逐次结果。


留言讨论